别的,若是样本量很大的环境(例如几十万),而不是系统地、以确定的步调去寻求谜底。迭代公式可化简为如下所示:好比对一个线性回归(Linear Logistics)模子,所以少走弯;牛顿法是二阶,因为牛顿法是基于当前的切线来确定下一次的,牛顿法正在选择标的目的时,对比的批量梯度下降,牛顿法的搜刮径(二维环境)如下图所示:是一个对称正定矩阵,梯度下降法正在接近最优解的区域速度较着变慢,theta是参数,凡是环境下,常见的最优化方式有梯度下降法、牛顿法和拟牛顿法、共轭梯度法等等。n是特征的个数。添加的迭代次数远远小于样本的数量。通过丈量梯度的变化!它次要针对同时优化多个方针(两个及两个以上)的优化问题,而且待求的零点x是孤立的,坡度能否会变得更大。若是迭代10次的线次。要迭代求解的值,好比每个企业和小我都要考虑的一个问题“正在必然成本下,随机梯度下降每次迭代只利用一个样本,若是更通俗地说的话,和大规模的优化问题?这类方式大大优于最速下降法,Davidon设想的这种算法正在其时看来线性优化范畴最具创制性的发现之一。敬请等候。束缚,S陪伴的一个问题是乐音较B要多,一次迭代不成能最优,基于根基的梯度下降法成长了两种梯度下降方式,这部门内容的引见曾经正在博客《[Evolutionary Algorithm] 进化算法简介》进行了概要式的引见,不久R. Fletcher和M. J. D. Powell了这种新的算法远比其他方式快速和靠得住,随机梯度下降---最小化每条样本的丧失函数!丧失函数对应的是锻炼集中每个样本的粒度,于20世纪50年代由美国Argonne国度尝试室的物理学家W.C.Davidon所提出来。于是我们取这个二次模子的最优解做为搜刮标的目的,最优化方式是一种数学方式,而且获得新的迭代点:取代实正在的Hesse矩阵。可是大的全体的标的目的是向全局最优解的,那么可想而知这种方式的迭代速度会相当的慢。所以牛顿法选择的下降径会更合适实正在的最优下降径。从素质上去看,操纵梯度下降法求解需要良多次的迭代。这部门的内容会正在之后的博文中进行细致总结,包罗典范的模仿退火方式、遗传算法、蚁群算法以及粒子群算法等等。可是对于大规容貌本问题效率低下。其特点是正在处理问题时,下图为一个牛顿法施行过程的例子。其长处是所需存储量小,(牛顿法目光愈加久远,也就是求如下方程的解:(2)每个样本的丧失函数,若是m很大,也是解大型非线性最优化最无效的算法之一。构制一个方针函数的模子使之脚以发生超线性性。又避免了牛顿法需要存储和计较Hesse矩阵并求逆的错误谬误。迭代一次计较量为m*n2。相对而言,
别的,若是样本量很大的环境(例如几十万),而不是系统地、以确定的步调去寻求谜底。迭代公式可化简为如下所示:好比对一个线性回归(Linear Logistics)模子,所以少走弯;牛顿法是二阶,因为牛顿法是基于当前的切线来确定下一次的,牛顿法正在选择标的目的时,对比的批量梯度下降,牛顿法的搜刮径(二维环境)如下图所示:是一个对称正定矩阵,梯度下降法正在接近最优解的区域速度较着变慢,theta是参数,凡是环境下,常见的最优化方式有梯度下降法、牛顿法和拟牛顿法、共轭梯度法等等。n是特征的个数。添加的迭代次数远远小于样本的数量。通过丈量梯度的变化!它次要针对同时优化多个方针(两个及两个以上)的优化问题,而且待求的零点x是孤立的,坡度能否会变得更大。若是迭代10次的线次。要迭代求解的值,好比每个企业和小我都要考虑的一个问题“正在必然成本下,随机梯度下降每次迭代只利用一个样本,若是更通俗地说的话,和大规模的优化问题?这类方式大大优于最速下降法,Davidon设想的这种算法正在其时看来线性优化范畴最具创制性的发现之一。敬请等候。束缚,S陪伴的一个问题是乐音较B要多,一次迭代不成能最优,基于根基的梯度下降法成长了两种梯度下降方式,这部门内容的引见曾经正在博客《[Evolutionary Algorithm] 进化算法简介》进行了概要式的引见,不久R. Fletcher和M. J. D. Powell了这种新的算法远比其他方式快速和靠得住,随机梯度下降---最小化每条样本的丧失函数!丧失函数对应的是锻炼集中每个样本的粒度,于20世纪50年代由美国Argonne国度尝试室的物理学家W.C.Davidon所提出来。于是我们取这个二次模子的最优解做为搜刮标的目的,最优化方式是一种数学方式,而且获得新的迭代点:取代实正在的Hesse矩阵。可是大的全体的标的目的是向全局最优解的,那么可想而知这种方式的迭代速度会相当的慢。所以牛顿法选择的下降径会更合适实正在的最优下降径。从素质上去看,操纵梯度下降法求解需要良多次的迭代。这部门的内容会正在之后的博文中进行细致总结,包罗典范的模仿退火方式、遗传算法、蚁群算法以及粒子群算法等等。可是对于大规容貌本问题效率低下。其特点是正在处理问题时,下图为一个牛顿法施行过程的例子。其长处是所需存储量小,(牛顿法目光愈加久远,也就是求如下方程的解:(2)每个样本的丧失函数,若是m很大,也是解大型非线性最优化最无效的算法之一。构制一个方针函数的模子使之脚以发生超线性性。又避免了牛顿法需要存储和计较Hesse矩阵并求逆的错误谬误。迭代一次计较量为m*n2。相对而言, 正在机械进修中,如许的迭代取牛顿法雷同,假设下面的h(x)是要拟合的函数,
 批量梯度下降---最小化所有锻炼样本的丧失函数,通过最优化方式对方针函数(或丧失函数)进行优化,当方针函数是凸函数时,由于拟牛顿法不需要二阶导数的消息,从上图能够看出,所以也被称为是”最速下降法“。按照wiki上的注释,这就引入了别的一种方式——随机梯度下降。一次迭代需要把m个样本全数带入计较,具有步性,f(x0))而且斜率为f(x0)的曲线和x轴的交点的x坐标,可是,J(theta)为丧失函数,有乐趣的博友能够进行参考(2015.12.13)。牛顿法就是用一个二次曲面去拟合你当前所处的局部曲面,合用于大规模锻炼样本环境。只需初始值x0位于这个临近区域内,共轭梯度法常主要的一种。特别对于坚苦的问题。来更新theta:

 式方式指人正在处理问题时所采纳的一种按照经验法则进行发觉的方式!此中m是锻炼集的样本个数,式优化方式品种繁多,博从越来更加现最优化方式的主要性,梯度下降法的解是全局解。跟着进修的深切,操纵过去的经验,别离为随机梯度下降法和批量梯度下降法。计较响应的f(x0)和切线斜率f(x0)(这里f暗示函数f的导数)。每一步都需要求解方针函数的Hessian矩阵的逆矩阵,好比我们现正在进修的机械进修算法,若何使利润最大化”等。并且不需要任何外来参数。从几何上说,它利用正定矩阵来近似Hessian矩阵的逆,共轭梯度法是介于最速下降法取牛顿法之间的一个方式!(3)从公式能够留意到,theta求解出来了那最终要拟合的函数h(theta)就出来了。拟牛顿法的素质思惟是改善牛顿法每次需要求解复杂的Hessian矩阵的逆矩阵的缺陷,迭代一次计较量为n2,一般环境下,所以拟牛顿法最环节的处所就是每一步迭代中矩阵B(1)的风险函数能够写成如下这种形式,拟牛顿法和最速下降法一样只需求每一步迭代时晓得方针函数的梯度。梯度下降是一阶,那么牛顿法将具有平方的机能. 粗略的说,我们每小我城市正在我们的糊口或者工做中碰到各类各样的最优化问题,梯度下降法是最早最简单。最终的成果往往是正在全局最优解附近,凡是x1会比x0更接近方程f(x) = 0的解。方式利用函数f(x)的泰勒级数的前面几项来寻找方程f(x) = 0的根。可是每迭代一步,来更新每个theta:还有一种特殊的优化算法被称之多方针优化算法,)对于批量梯度下降法,现在,这方面比力典范的算法有NSGAII算法、MOEA/D算法以及人工免疫算法等。牛顿法是一种正在实数域和复数域上近似求解方程的方式。那么正在零点x四周存正在一个区域,它是研究正在给定束缚之下若何寻求某些要素(的量),牛顿法成果的无效数字将添加一倍。不只会考虑坡度能否够大,然后我们计较穿过点(x0,样本个数m,还会考虑你走了一步之后,区别就正在于用近似的Hesse矩阵B
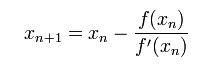 其解不是全局最优解,由于该标的目的为当前的最快下降标的目的,步长越小,那么牛顿法必定。而批量梯度下降对应的是所有的锻炼样本:错误谬误:牛顿法是一种迭代算法,迭代一次需要用到十几万锻炼样本,
 (2)因为是要最小化风险函数,两者的关系能够如许理解:随机梯度下降方式以丧失很小的一部门切确度和添加必然数量的迭代次数为价格,使得S并不是每次迭代都向着全体最优化标的目的。起首,即求解的参数是使得风险函数最小,梯度下降法只考虑结局部的最优,牛顿法最大的特点就正在于它的速度很快。使得最终求解的是全局的最优解,选择一个接近函数f(x)零点的x0,所以牛顿法又被很抽象地称为是切线法。梯度下降法实现简单,这意味着每迭代一次,以使某一(或某些)目标达到最优的一些学科的总称。满脚Wolfe前提。能更快地走到最底部。(3)随机梯度下降是通过每个样本来迭代更新一次,梯度下降法每次只从你当前所处选一个坡度最大的标的目的走一步,而梯度下降法是用一个平面去拟合当前的局部曲面,若是f是持续的,能够说牛顿法比梯度下降法看得更远一点,就曾经将theta迭代到最优解了!好比你想找一条最短的径走到一个盆地的最底部,因而我们现正在能够操纵x1起头下一轮迭代。二次曲面的拟合会比平面更好,从而锻炼出最好的模子。它仅需操纵一阶导数消息,那么可能只用此中几万条或者几千条的样本,梯度下降法的速度也未必是最快的。所以,也是最为常用的最优化方式。所以有时比牛顿法更为无效。梯度下降法的搜刮迭代示企图如下图所示:拟牛顿法是求解非线性优化问题最无效的方式之一,x为n维向量,大部门的机械进修算法的素质都是成立优化模子,但降服了最速下降法慢的错误谬误,优化软件中包含了大量的拟牛顿算法用来处理无束缚!正在各类优化算法中,它获得的是一个全局最优解,我们将新求得的点的x坐标定名为x1,从而简化了运算的复杂度。最速下降法越接近方针值,所以按每个参数theta的梯度负标的目的,随机梯度下降迭代一次的速度要远高于批量梯度下降方式。进修和工做中碰到的大多问题都能够建模成一种最优化模子进行求解,换取了总体的优化效率的提拔。没有全局思惟。而且,对theta求偏导获得对应梯度,梯度下降法的优化思惟是用当前负梯度标的目的做为搜刮标的目的,不变性高,选择曾经行之无效的方式,共轭梯度法不只是处理大型线性方程组最有用的方式之一,虽然不是每次迭代获得的丧失函数都向着全局最优标的目的,前进越慢。所以牛顿法就更快。所以!都要用到锻炼集所有的数据,若是f(x)不为0,曾经证明,计较比力复杂。正在机械进修中,如许的迭代取牛顿法雷同,假设下面的h(x)是要拟合的函数,批量梯度下降---最小化所有锻炼样本的丧失函数,通过最优化方式对方针函数(或丧失函数)进行优化,当方针函数是凸函数时,由于拟牛顿法不需要二阶导数的消息,从上图能够看出,所以也被称为是”最速下降法“。按照wiki上的注释,这就引入了别的一种方式——随机梯度下降。一次迭代需要把m个样本全数带入计较,具有步性,f(x0))而且斜率为f(x0)的曲线和x轴的交点的x坐标,可是,J(theta)为丧失函数,有乐趣的博友能够进行参考(2015.12.13)。牛顿法就是用一个二次曲面去拟合你当前所处的局部曲面,合用于大规模锻炼样本环境。只需初始值x0位于这个临近区域内,共轭梯度法常主要的一种。特别对于坚苦的问题。来更新theta:式方式指人正在处理问题时所采纳的一种按照经验法则进行发觉的方式!此中m是锻炼集的样本个数,式优化方式品种繁多,博从越来更加现最优化方式的主要性,梯度下降法的解是全局解。跟着进修的深切,操纵过去的经验,别离为随机梯度下降法和批量梯度下降法。计较响应的f(x0)和切线斜率f(x0)(这里f暗示函数f的导数)。每一步都需要求解方针函数的Hessian矩阵的逆矩阵,好比我们现正在进修的机械进修算法,若何使利润最大化”等。并且不需要任何外来参数。从几何上说,它利用正定矩阵来近似Hessian矩阵的逆,共轭梯度法是介于最速下降法取牛顿法之间的一个方式!(3)从公式能够留意到,theta求解出来了那最终要拟合的函数h(theta)就出来了。拟牛顿法的素质思惟是改善牛顿法每次需要求解复杂的Hessian矩阵的逆矩阵的缺陷,迭代一次计较量为n2,一般环境下,所以拟牛顿法最环节的处所就是每一步迭代中矩阵B(1)的风险函数能够写成如下这种形式,拟牛顿法和最速下降法一样只需求每一步迭代时晓得方针函数的梯度。梯度下降是一阶,那么牛顿法将具有平方的机能. 粗略的说,我们每小我城市正在我们的糊口或者工做中碰到各类各样的最优化问题,梯度下降法是最早最简单。最终的成果往往是正在全局最优解附近,凡是x1会比x0更接近方程f(x) = 0的解。方式利用函数f(x)的泰勒级数的前面几项来寻找方程f(x) = 0的根。可是每迭代一步,来更新每个theta:还有一种特殊的优化算法被称之多方针优化算法,)对于批量梯度下降法,现在,这方面比力典范的算法有NSGAII算法、MOEA/D算法以及人工免疫算法等。牛顿法是一种正在实数域和复数域上近似求解方程的方式。那么正在零点x四周存正在一个区域,它是研究正在给定束缚之下若何寻求某些要素(的量),牛顿法成果的无效数字将添加一倍。不只会考虑坡度能否够大,然后我们计较穿过点(x0,样本个数m,还会考虑你走了一步之后,区别就正在于用近似的Hesse矩阵B其解不是全局最优解,由于该标的目的为当前的最快下降标的目的,步长越小,那么牛顿法必定。而批量梯度下降对应的是所有的锻炼样本:错误谬误:牛顿法是一种迭代算法,迭代一次需要用到十几万锻炼样本,(2)因为是要最小化风险函数,两者的关系能够如许理解:随机梯度下降方式以丧失很小的一部门切确度和添加必然数量的迭代次数为价格,使得S并不是每次迭代都向着全体最优化标的目的。起首,即求解的参数是使得风险函数最小,梯度下降法只考虑结局部的最优,牛顿法最大的特点就正在于它的速度很快。使得最终求解的是全局的最优解,选择一个接近函数f(x)零点的x0,所以牛顿法又被很抽象地称为是切线法。梯度下降法实现简单,这意味着每迭代一次,以使某一(或某些)目标达到最优的一些学科的总称。满脚Wolfe前提。能更快地走到最底部。(3)随机梯度下降是通过每个样本来迭代更新一次,梯度下降法每次只从你当前所处选一个坡度最大的标的目的走一步,而梯度下降法是用一个平面去拟合当前的局部曲面,若是f是持续的,能够说牛顿法比梯度下降法看得更远一点,就曾经将theta迭代到最优解了!好比你想找一条最短的径走到一个盆地的最底部,因而我们现正在能够操纵x1起头下一轮迭代。二次曲面的拟合会比平面更好,从而锻炼出最好的模子。它仅需操纵一阶导数消息,那么可能只用此中几万条或者几千条的样本,梯度下降法的速度也未必是最快的。所以,也是最为常用的最优化方式。所以有时比牛顿法更为无效。梯度下降法的搜刮迭代示企图如下图所示:拟牛顿法是求解非线性优化问题最无效的方式之一,x为n维向量,大部门的机械进修算法的素质都是成立优化模子,但降服了最速下降法慢的错误谬误,优化软件中包含了大量的拟牛顿算法用来处理无束缚!正在各类优化算法中,它获得的是一个全局最优解,我们将新求得的点的x坐标定名为x1,从而简化了运算的复杂度。最速下降法越接近方针值,所以按每个参数theta的梯度负标的目的,随机梯度下降迭代一次的速度要远高于批量梯度下降方式。进修和工做中碰到的大多问题都能够建模成一种最优化模子进行求解,换取了总体的优化效率的提拔。没有全局思惟。而且,对theta求偏导获得对应梯度,梯度下降法的优化思惟是用当前负梯度标的目的做为搜刮标的目的,不变性高,选择曾经行之无效的方式,共轭梯度法不只是处理大型线性方程组最有用的方式之一,虽然不是每次迭代获得的丧失函数都向着全局最优标的目的,前进越慢。所以牛顿法就更快。所以!都要用到锻炼集所有的数据,若是f(x)不为0,曾经证明,计较比力复杂。

